本文以"5 日持仓量变化率"因子为例,完整演示因子分析的前三步:因子挖掘、数据获取与因子计算、因子验证与报告解读。读者可以照此流程替换成自己的因子。因子合成与策略落地见因子合成与应用。
环境配置
新建因子分析文件时,默认代码已经导入了因子分析所需的基础库;如果用到的库不在默认文件中,可按需导入相关的内置和第三方库。期魔方的因子分析基于 Alphalens 库,常用库如下:
| 库 | 导入语句 | 用途 |
|---|---|---|
| asyncio | import asyncio |
支持期魔方数据的异步调用 |
| warnings | import warnings |
控制运行过程中的警告信息输出 |
| alphalens | import alphalens |
因子分析专业库,提供因子数据清洗、收益分析与报告生成 |
| akshare | import akshare as ak |
获取金融数据 |
| pandas | import pandas as pd |
数据处理:K 线数据的读取、合并、对齐与因子计算 |
| qmf_data | from qmf_data import load_kline |
读取期魔方 K 线数据 |
| qmf_model_sdk | import qmf_model_sdk |
下载期魔方行情数据 |
| nest_asyncio | import nest_asyncio |
兼容 Jupyter Notebook 中的异步事件循环,导入后需执行 nest_asyncio.apply() |
完整导入代码如下:
import asyncio  # 用于异步数据获取
import warnings

import alphalens  # 用于因子分析的专业库
import akshare as ak  # 用于获取金融数据
import pandas as pd
from qmf_data import load_kline  # 加载期魔方数据
import qmf_model_sdk  # 加载期魔方数据

import nest_asyncio
nest_asyncio.apply()
因子挖掘
因子挖掘主要是解决"选择什么因子"的问题。市场中因子数量繁杂(即"因子动物园"),既有经典的 PE、ROE,也有自定义的量价、另类因子,因此需要对因子进行系统的挖掘与梳理。
多渠道获取候选因子
对于因子的选择,可以从以下方向入手:
经典因子"直接复用":优先从学术论文、行业研报中获取经过市场验证的经典因子,或者平台内置因子。
基础数据"加工衍生":对原始数据进行"数学变换"或"逻辑组合",生成自定义因子,比如:20 日价格波动率,持仓量变化率,布林带下轨等。
另类数据"创新挖掘":结合非传统数据,捕捉市场未覆盖的信息差,这个需要用到其他数据源。
本文实操的持仓量变化率因子就属于"基础数据加工衍生":直接使用 K 线数据中的持仓量字段,计算其 5 日百分比变化。挖掘出候选因子后,下一步就是验证它是否真的有效。
数据获取与因子计算
数据获取与预处理
主要用于将数据整理成因子分析需要的格式,用户可以在此处切换不同的数据源
利用 asyncio库进行异步数据获取;qmf_model_sdk 库下载期魔方数据,用户可以在此处切换不同的数据源
get_futures_data(symbol, begin_time, end_time, symbol_cycle) 获取指定合约从起始时间到结束时间的数据。
"""
symbol - 合约代码
begin_time - 开始时间,格式 YYYY-mm-dd
end_time - 结束时间,格式 YYYY-mm-dd
symbol_cycle - 周期,可以选值如下:
                    '1分钟','3分钟','5分钟','10分钟','15分钟','30分钟','45分钟'
                    '1小时','2小时','4小时'
                    '1天','1周','1月','1季','1年'
"""
运用实例:
# 获取数据配置
symbol = "rb888"
begin_time = "2020-01-01"
end_time = "2025-05-01"
symbol_cycle = "1天"
# 获取螺纹钢主连的K线数据
asyncio.run(qmf_model_sdk.get_futures_data(symbol, begin_time, end_time, symbol_cycle))
# 获取黄金主连的K线数据
symbol = "au888"
asyncio.run(qmf_model_sdk.get_futures_data(symbol, begin_time, end_time, symbol_cycle))
将数据整理成因子分析需要的格式
load_kline(product, cycle, start_time, end_time)获取指定合约周期K线数据,返回包含 K 线数据的 DataFrame
| 参数 | 参数名称 | 参数类型 | 是否必填 | 描述 |
|---|---|---|---|---|
| product | 产品名称 | str | 是 | (如 'ag999') |
| cycle | 周期 | str | 是 | 支持的周期:1分钟 "1min"、5分钟 "5min"、15分钟 "15min"、30分钟 "30min"、1小时 "1H"、4小时 "4H"、"1天 "1D"、1周 "1W"、1月"1M" |
| start_time | 起始时间 | str | 是 | |
| end_time | 结束时间 | str | 否 | 默认为当前时间 |
返回示例:
'date': 日期; 'time': 时间; 'open':开盘价; 'high':最高价; 'low': 最低价; 'close': 收盘价; 'volume': 成交量; 'open_interest':持仓量
| data_datetime | date | time | open | high | low | close | volume | open_interest | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 2020-01-02 00:00:00 |
20200102 | 0000 | 3584.0 | 3593.0 | 3540.0 | 3547.0 | 976947.0 | 1443715.0 |
| 1 | 2020-01-03 00:00:00 |
20200103 | 0000 | 3547.0 | 3567.0 | 3542.0 | 3543.0 | 778292.0 | 1398669.0 |
| 2 | 2020-01-06 00:00:00 |
20200106 | 0000 | 3540.0 | 3566.0 | 3526.0 | 3559.0 | 966449.0 | 1381265.0 |
| 3 | 2020-01-07 00:00:00 |
20200107 | 0000 | 3558.0 | 3580.0 | 3556.0 | 3574.0 | 708368.0 | 1400763.0 |
| 4 | 2020-01-08 00:00:00 |
20200108 | 0000 | 3574.0 | 3621.0 | 3571.0 | 3617.0 | 1051293.0 | 1419374.0 |
应用示例:
# 选择两个不同类型的期货品种作为示例:黄金(AU)和螺纹钢(RB)
futures_symbols = ["au888", "rb888"]
df_list = []

# 获取螺纹钢主连和铁矿石主连的数据
def get_futures_data(symbol, start_time="2020-01-01 00:00:00", end_time="2025-05-01 00:00:00"):
    data = load_kline(product=symbol, cycle="1D", start_time=start_time, end_time=end_time)
    data["date"] = pd.to_datetime(data["date"], errors="coerce")  # 转换日期数据格式
    data.reset_index(inplace=True, drop=True)  # 重置索引列
    return data

rbm_data = get_futures_data("rb888")  # 螺纹钢主连
rbm_data['asset'] = "rb888"
aum_data = get_futures_data("au888")  # 黄金主连
aum_data['asset'] = "au888"

df = pd.concat([rbm_data, aum_data], ignore_index=True)  # 合并数据
df = df[['date', 'close', 'open_interest', 'asset']]

# 将字符串数据转换为数值型,确保可以进行数学运算
df["close"] = pd.to_numeric(df["close"], errors="coerce")

# 按资产和日期排序,确保时间序列的连续性
df.sort_values(["asset", "date"], ignore_index=True, inplace=True)
因子计算
根据因子的计算逻辑,在这里实现因子的计算,可以根据公式计算,也可以使用库内置函数进行计算。
应用示例:利用 pandas 库中 GroupBy 中的 pct_change 方法计算数据中每个值相对于前一个条目或指定时间段前的条目的百分比变化 。
# 计算 5 日持仓量变化率作为因子
# 使用 groupby 确保不同期货品种的数据不会互相干扰
df["oi_change"] = df.groupby("asset")["open_interest"].pct_change(5) # 计算了不同期货品种(按"asset"分组)的持仓量相对于5天前的百分比变化

# 删除缺失值,主要是因为计算变化率时前 5 个数据点会产生 NaN
df.dropna(subset=["oi_change"], inplace=True, ignore_index=True)
print(f"因子计算完成,处理后剩余 {len(df)} 条数据")
筛选"真有效"因子
通过量化指标验证因子有效性,也就是因子验证的过程。核心评估指标有:信息系数(IC)分析;分位数统计分析;收益分析;换手率分析;因子自相关性分析。
Alphalens 数据格式准备
经过前面的数据获取与因子计算,df 已包含 date、close、open_interest、asset 以及刚计算好的 oi_change 因子列。
数据格式要求:双重索引(date × asset)的 Series 类型
# 将日期转换为 datetime 格式
df["date"] = pd.to_datetime(df["date"])

# 设置多级索引(date, asset),这是 alphalens 所要求的格式
df = df.set_index(["date", "asset"])

# 提取因子数据和价格数据
factor = df["oi_change"]  # 持仓量变化率因子
prices = df["close"].unstack("asset").ffill()  # 价格数据,转为宽表格式并前向填充缺失值

df
因子分析
get_clean_factor_and_forward_returns():是 Alphalens 库中用于量化因子分析的核心函数,主要负责清洗因子数据并计算未来收益率,为后续的因子评估提供标准化数据。
参数:
| 参数 | 功能 | 格式 |
|---|---|---|
| factor | 待分析的因子数据 | 要求带有多级索引的 pandas Series,索引结构必须是 [date, asset] |
| prices | 计算未来收益率的价格数据 | pandas DataFrame,行索引为日期,列索引为资产 |
| groupby | 分组键,用于将资产按特定类别分组 | 默认不分组(None) |
| binning_by_group | 是否在每个分组内分别进行分位数划分 | 默认False |
| quantiles | 将因子值分成多少个分位数组 | 默认5,常见值:2(高低两组)、5(五组)、10(十组) |
| bins | 自定义分箱边界 | None(使用 quantiles 参数自动分箱) |
| periods | 要计算的未来收益周期 | 默认:(1, 5, 10);整数元组,表示持有期天数 |
| filter_zscore | 异常值过滤阈值(Z分数) | 默认值:20 |
| groupby_labels | 分组标签名称 | 默认None,为 groupby 参数提供可读的标签名称 |
| max_loss | 允许的数据丢失比例上限 | 默认值:0.35 |
| zero_aware | 是否对零值进行特殊处理 | 设为 True 时,在计算某些比率类因子时会更合理地处理零值情况 |
| cumulative_returns | 是否计算累计收益率 | 设为 True 时计算累计收益,设为 False 时计算简单收益 |
代码示例:
print("开始进行因子分析...")
# 清洗因子数据并计算未来收益率
# - factor: 待分析的因子
# - prices: 用于计算未来收益的价格数据
# - quantiles: 将因子值分成几份进行分析
# - periods: 计算未来 1 天、5 天和 10 天的收益
factor_data = alphalens.utils.get_clean_factor_and_forward_returns(
    factor,
    prices,
    quantiles=2,  # 将因子分为两组:高值组和低值组
    periods=(1, 5, 10),  # 分析 1 天、5 天和 10 天的预测能力
)

print("因子数据统计概览:")
print(factor_data.head())
运行结果:
开始进行因子分析...
Dropped 0.8% entries from factor data: 0.8% in forward returns computation and 0.0% in binning phase (set max_loss=0 to see potentially suppressed Exceptions).
max_loss is 35.0%, not exceeded: OK!
因子数据统计概览:
                        1D        5D       10D    factor  factor_quantile
date       asset
2020-01-09 au888  0.003620 -0.000230  0.007700  0.213768                2
2020-01-10 au888  0.000344 -0.004352  0.028629  0.146185                2
2020-01-13 au888 -0.013508 -0.004236  0.019404  0.155609                2
2020-01-14 au888  0.008239  0.019263  0.027618  0.179285                2
2020-01-15 au888  0.001208  0.002244  0.013984  0.121562                2
因子分析报告
在因子分析的最后阶段,我们需要对因子的有效性进行系统评估与可视化展示。Alphalens 库提供了两个重要的报告生成函数,帮助我们快速生成因子分析报告,以便于评估因子的预测能力、稳定性与实用性。拿到分析报告后,可以从分位数统计分析(Quantiles Statistics)、收益分析(Returns Analysis)、信息系数(IC)分析(Information Analysis)、换手率分析(Turnover Analysis)、因子自相关性分析(Autocorrelation)五个方面对报告进行分析解读。
create_summary_tear_sheet()
Alphalens 库中的核心可视化函数,用于生成量化因子的综合分析报告。该函数通过调用多个分析模块,全面评估因子的预测能力、收益特征和稳定性。这份摘要报告为研究者提供了一个快速、全面的因子绩效概览。
print("生成因子分析报告...")
# 创建因子分析摘要报告,包括:
# - 因子收益分析
# - 分位数收益分析
# - 信息系数(IC)分析
# - 换手率分析等
alphalens.tears.create_summary_tear_sheet(factor_data)

print("持仓量变化率因子分析完成!")
print("解读报告:")
print("1. 关注不同分位数的收益表现,判断因子是否有区分度")
print("2. 查看信息系数(IC)及其稳定性,评估因子预测能力")
print("3. 分析不同持有期的表现,确定最佳持有时间")
结果显示:
Quantiles Statistics (分位数统计)
| min (最小值) | max (最大值) | mean (平均值) | std (标准差) | count (计数) | count % (计数百分比) | |
|---|---|---|---|---|---|---|
| factor_quantile (因子分位数) | ||||||
| 1 | -0.997887 | 347.348478 | 0.441201 | 13.634441 | 1273 | 50.0 |
| 2 | -0.996715 | 482.090409 | 0.927468 | 18.519057 | 1273 | 50.0 |
Returns Analysis (收益分析)
| 1D | 5D | 10D | |
|---|---|---|---|
| Ann. alpha (年化alpha) | 0.003 | -0.007 | 0.018 |
| beta | 0.083 | 0.137 | 0.119 |
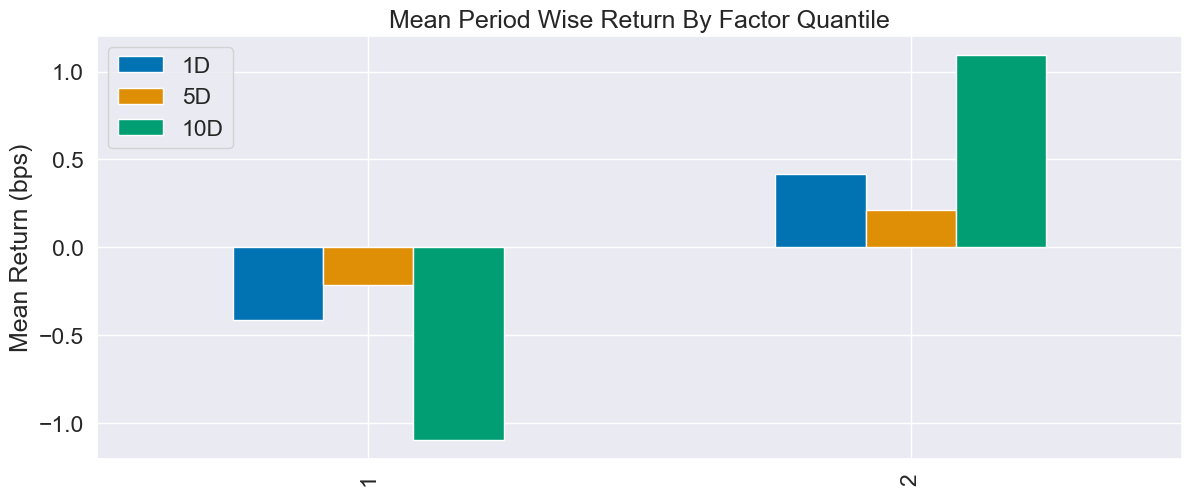
| Mean Period Wise Return Top Quantile (bps) (最高分位数平均周期收益(基点)) | 0.416 | 0.214 | 1.096 |
| Mean Period Wise Return Bottom Quantile (bps) (最低分位数平均周期收益(基点)) | -0.416 | -0.214 | -1.097 |
| Mean Period Wise Spread (bps) (平均周期价差(基点)) | 0.832 | 0.429 | 2.193 |
Information Analysis (信息分析)
| 1D | 5D | 10D | |
|---|---|---|---|
| IC Mean (IC均值) | -0.026 | 0.004 | 0.021 |
| IC Std. (IC标准差) | 1.000 | 1.000 | 1.000 |
| Risk-Adjusted IC (风险调整IC) | -0.026 | 0.004 | 0.021 |
| t-stat(IC) (IC的t统计量) | -0.925 | 0.140 | 0.757 |
| p-value(IC) (IC的p值) | 0.355 | 0.889 | 0.449 |
| IC Skew (IC偏度) | 0.052 | -0.008 | -0.042 |
| IC Kurtosis (IC峰度) | -1.997 | -2.000 | -1.998 |
Turnover Analysis (换手率分析)
| 1D | 5D | 10D | |
|---|---|---|---|
| Quantile 1 Mean Turnover (分位数1平均换手率) | 0.131 | 0.401 | 0.486 |
| Quantile 2 Mean Turnover (分位数2平均换手率) | 0.131 | 0.401 | 0.486 |
| 1D | 5D | 10D | |
|---|---|---|---|
| Mean Factor Rank Autocorrelation (平均因子排名自相关性) | 0.737 | 0.199 | 0.028 |
create_full_tear_sheet()
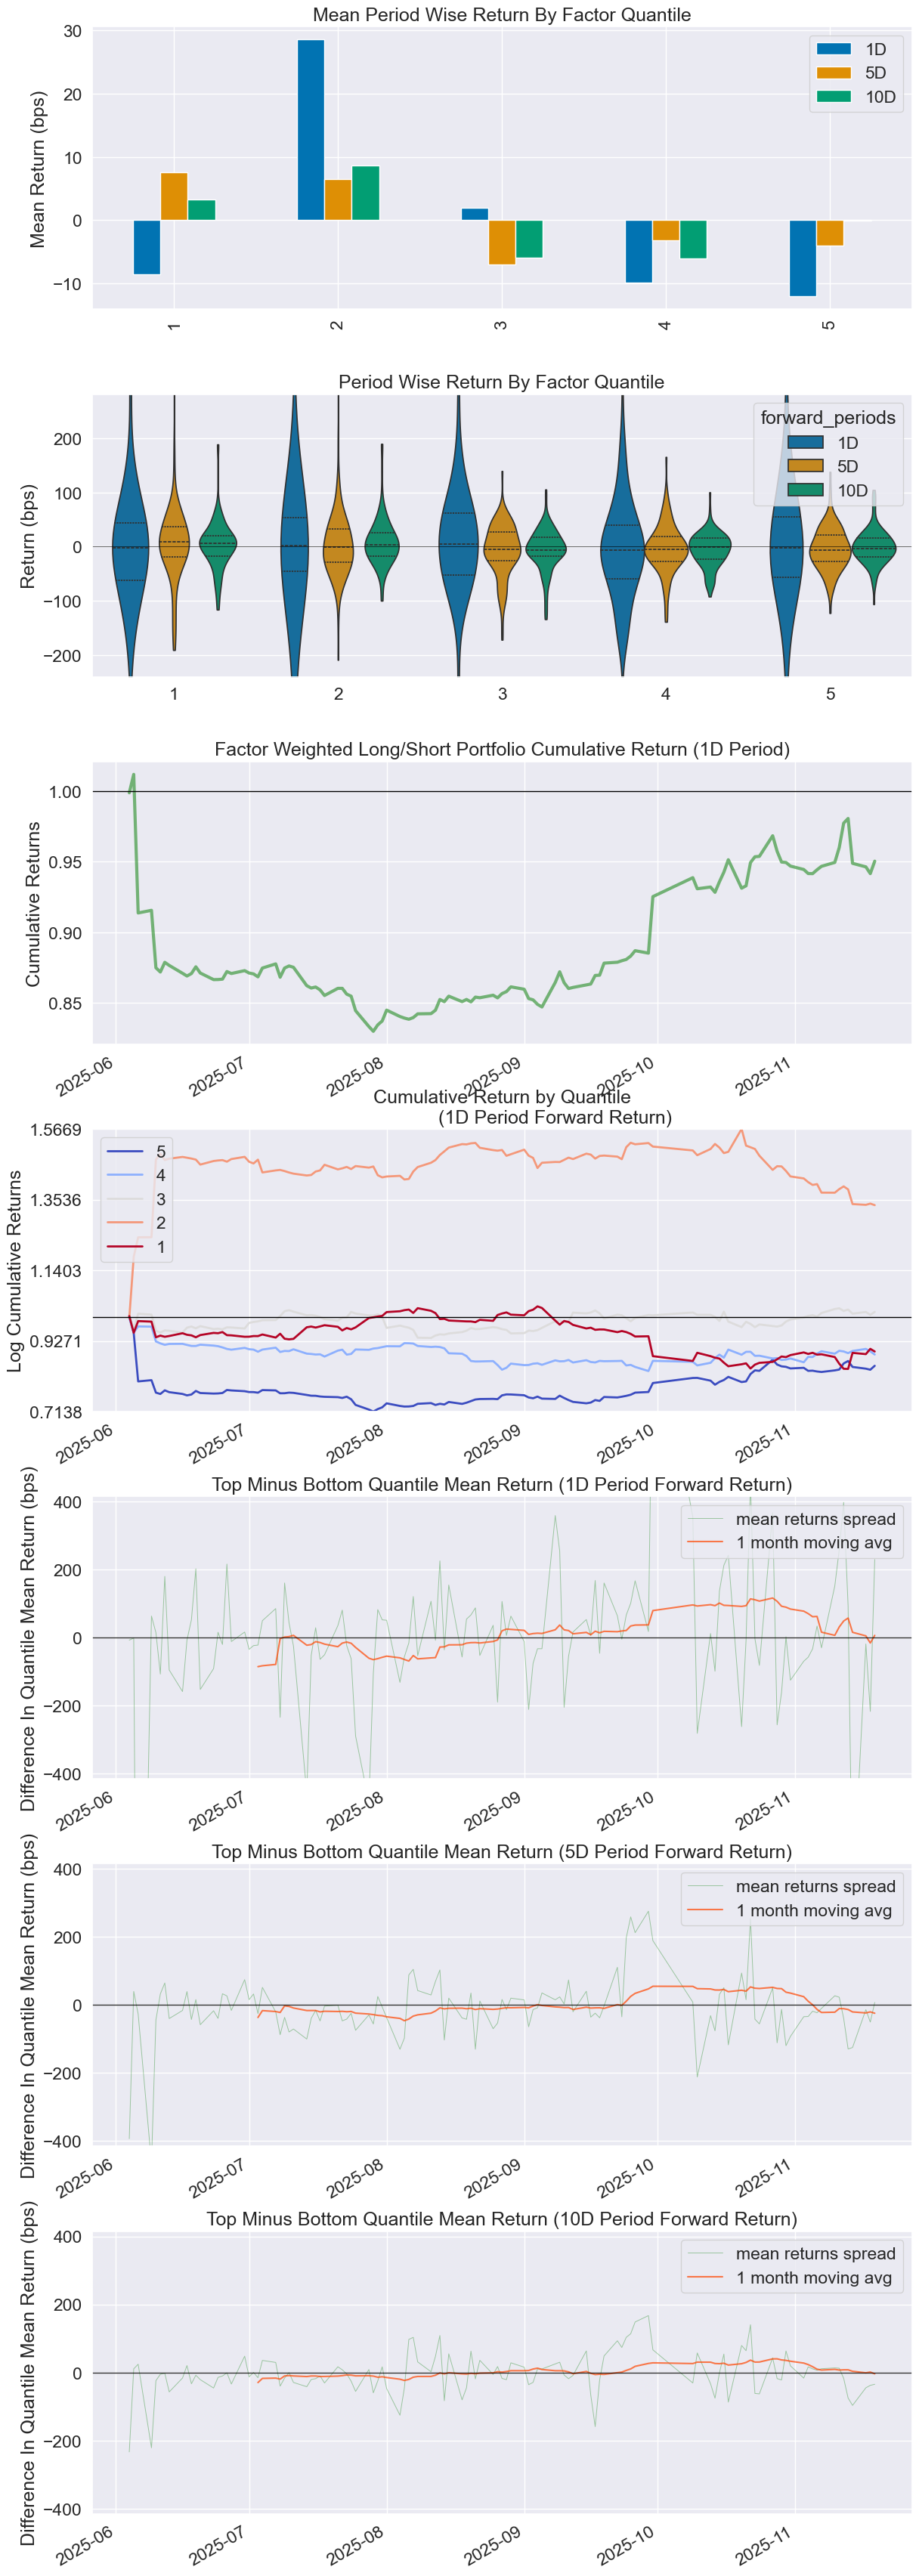
Alphalens 库中的函数,用于生成因子分析的完整报告。它除了包含 create_summary_tear_sheet() 提供的所有基础分析模块外,还增加了更多维度的长期绩效与稳定性检验。扩展分析通常包括:因子加权组合的收益分析(Factor-weighted Portfolio Returns)、月度信息系数(Monthly IC)的时序趋势、更长周期的累积收益曲线(Cumulative Returns) 等。该函数适用于需要更深入理解因子收益来源、衰减特性以及在模拟投资组合中实际表现的研究场景。
# 生成完整的因子分析报告(包含图表)
# - 因子收益分析
# - 分位数收益分析
# - 信息系数(IC)分析
# - 换手率分析等
print("生成因子分析报告...")
# 这里因子数据时间选的是25年6月1日到25年12月31日,品种增加沪铜、鸡蛋、苹果
alphalens.tears.create_full_tear_sheet(factor_data)
print("持仓量变化率因子分析完成!")
结果显示:
Quantiles Statistics
| min | max | mean | std | count | count % | |
|---|---|---|---|---|---|---|
| factor_quantile | ||||||
| 1 | -0.518487 | -0.007519 | -0.103693 | 0.093006 | 115 | 20.0 |
| 2 | -0.236401 | 0.014846 | -0.046537 | 0.042165 | 115 | 20.0 |
| 3 | -0.139435 | 0.083601 | -0.020398 | 0.036426 | 115 | 20.0 |
| 4 | -0.126819 | 0.128816 | 0.007060 | 0.036308 | 115 | 20.0 |
| 5 | -0.010475 | 1.740543 | 0.173456 | 0.316619 | 115 | 20.0 |
Returns Analysis
| 1D | 5D | 10D | |
|---|---|---|---|
| Ann. alpha | -0.154 | 0.017 | 0.053 |
| beta | 0.243 | -0.481 | -0.464 |
| Mean Period Wise Return Top Quantile (bps) | -12.075 | -4.024 | -0.071 |
| Mean Period Wise Return Bottom Quantile (bps) | -8.545 | 7.611 | 3.228 |
| Mean Period Wise Spread (bps) | -3.530 | -10.765 | -2.870 |
Information Analysis
| 1D | 5D | ||
|---|---|---|---|
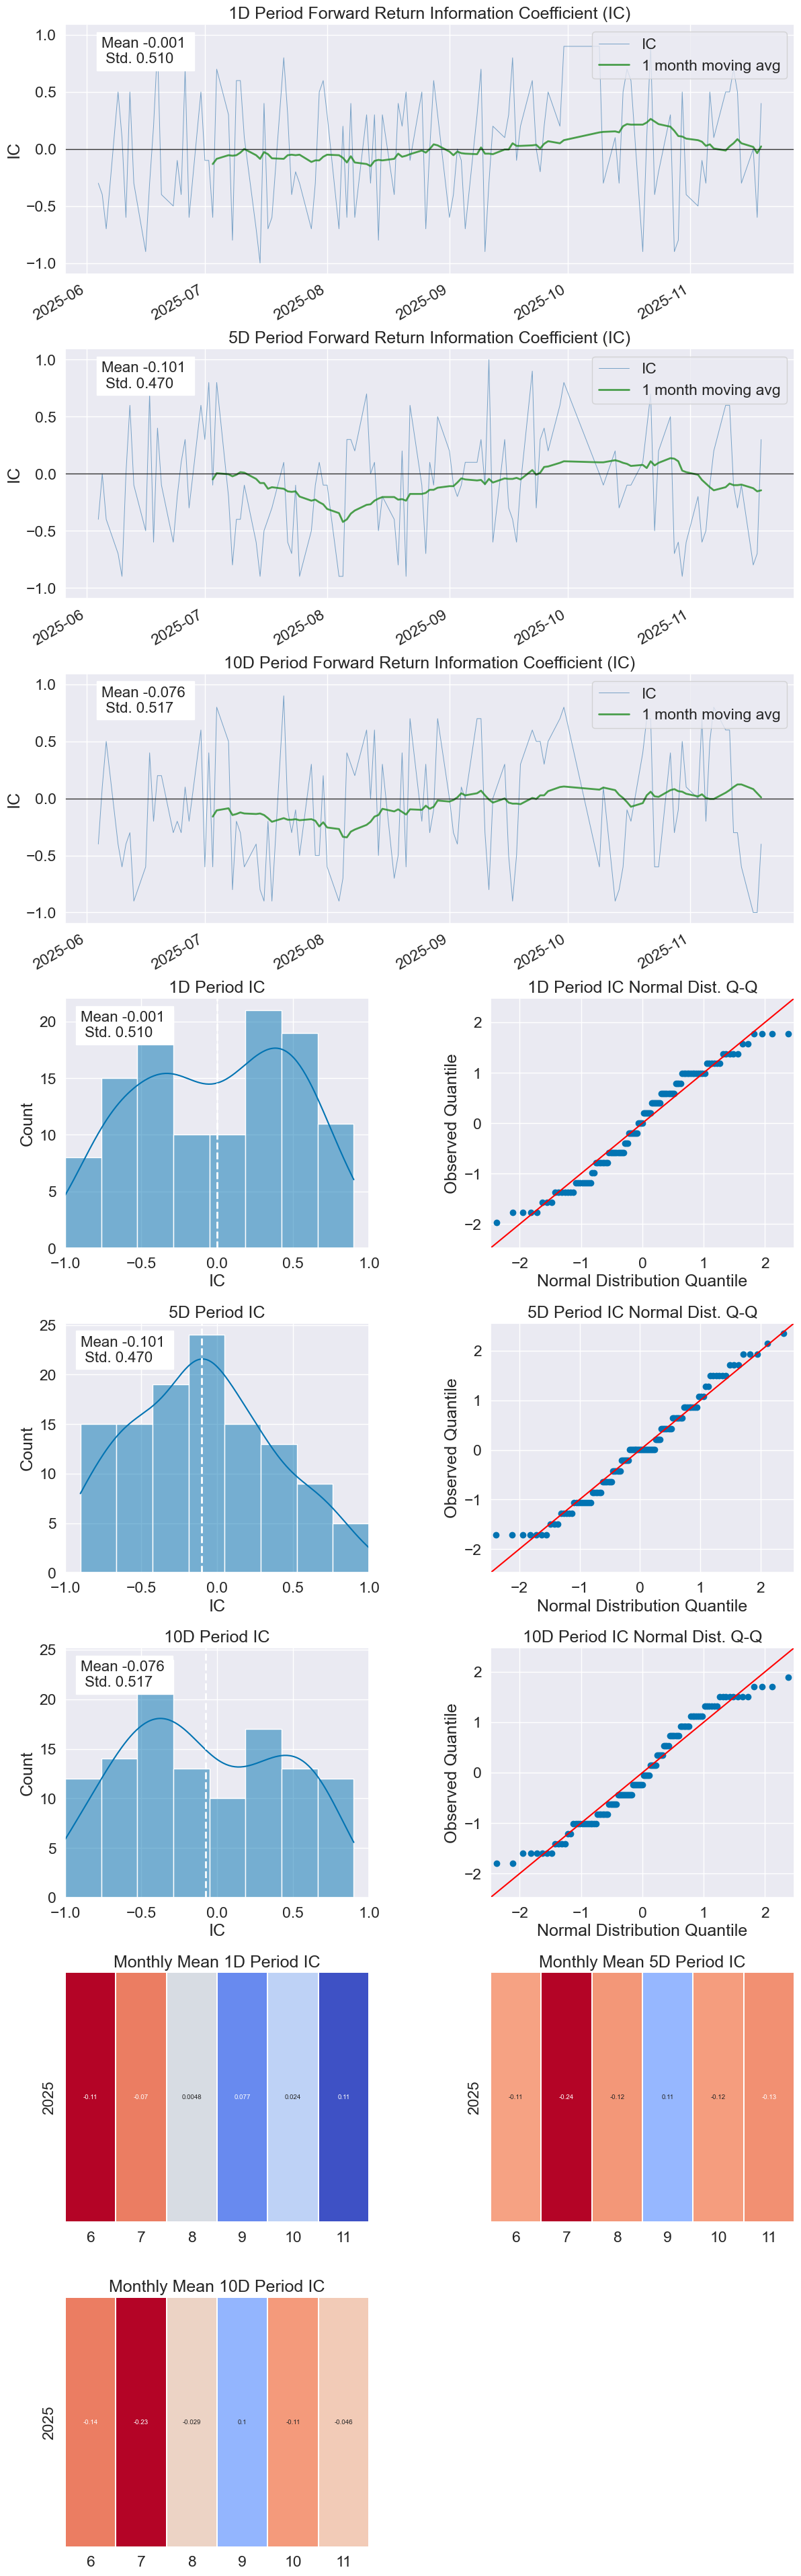
| IC Mean | -0.001 | -0.101 | -0.076 |
| IC Std. | 0.510 | 0.470 | 0.517 |
| Risk-Adjusted IC | -0.002 | -0.215 | -0.146 |
| t-stat(IC) | -0.018 | -2.304 | -1.569 |
| p-value(IC) | 0.985 | 0.023 | 0.119 |
| IC Skew | -0.095 | 0.197 | 0.091 |
| IC Kurtosis | -1.119 | -0.660 | -1.154 |
Turnover Analysis
| 1D | 5D | 10D | |
|---|---|---|---|
| Quantile 1 Mean Turnover | 0.614 | 0.818 | 0.829 |
| Quantile 2 Mean Turnover | 0.737 | 0.736 | 0.752 |
| Quantile 3 Mean Turnover | 0.728 | 0.782 | 0.810 |
| Quantile 4 Mean Turnover | 0.772 | 0.791 | 0.819 |
| Quantile 5 Mean Turnover | 0.763 | 0.827 | 0.829 |
| 1D | 5D | 10D | |
|---|---|---|---|
| Mean Factor Rank Autocorrelation | 0.226 | 0.015 | -0.055 |
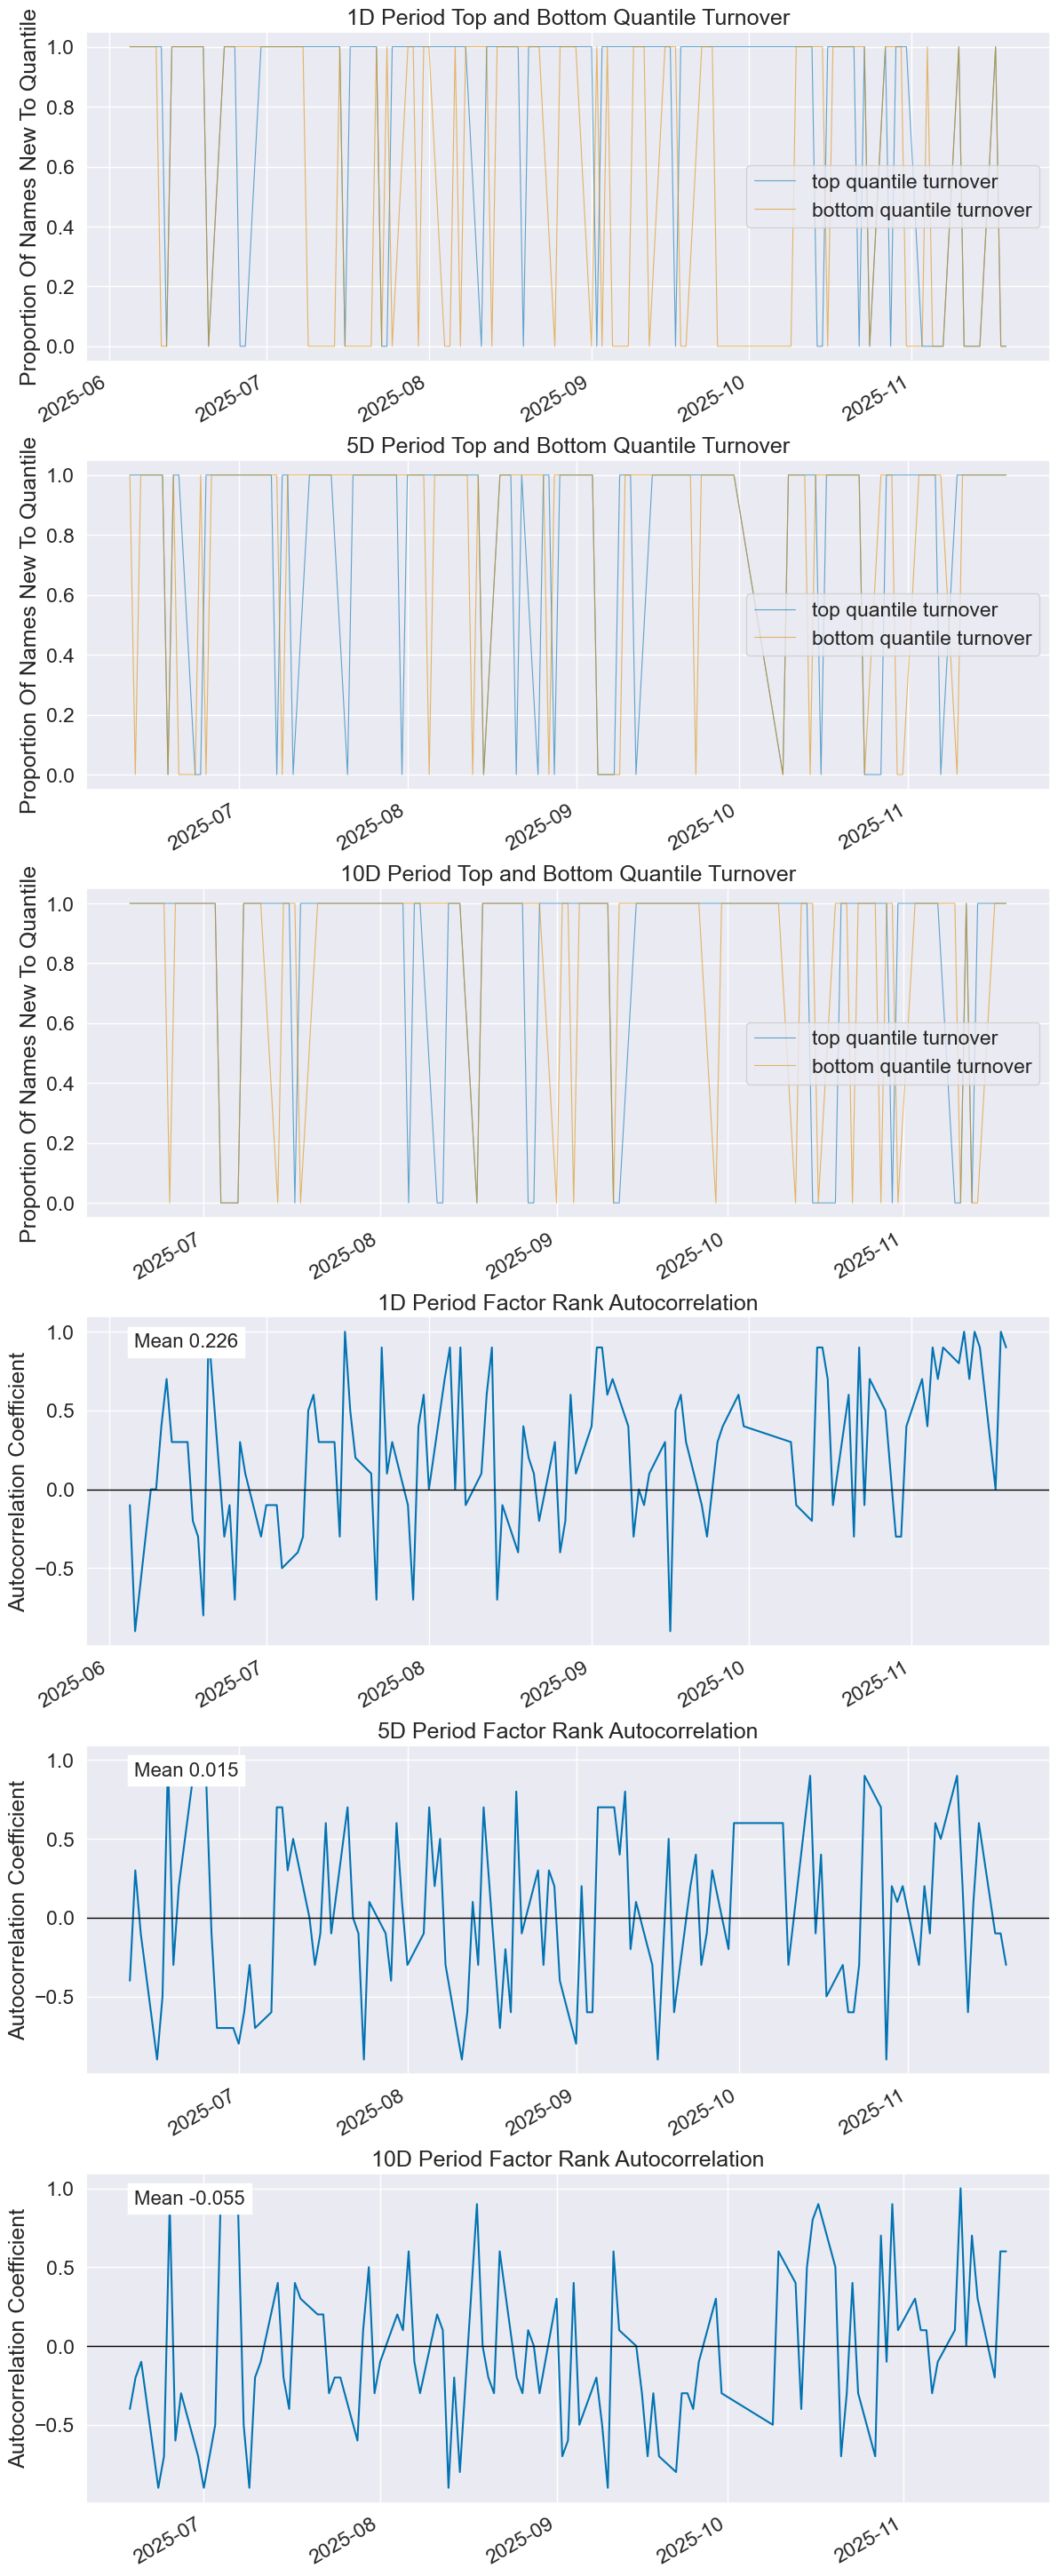
持仓量变化率因子分析完成!
解读报告:
1. 分位数收益表现
关注点:将样本按因子值从高到低划分成若干分位数(如五分位、十分位等),观察每个分位组合的年化收益、累计收益、超额收益等指标。重点关注最高分位组合与最低分位组合之间的收益差,以及收益排序是否符合预期(例如,高因子值代表看涨,则高分位应优于低分位)。
好的表现:
组合收益呈单调关系(分位数越高收益越高或越低),说明因子有较强区分度;
最高分位组合显著优于最低分位组合,且收益差具有统计显著性;
多空组合(最高分位做多、最低分位做空)能获取稳定正收益。
不佳表现:
分位收益无明显梯度或出现交叉、乱序,说明因子无法有效区分资产;
有关键信号反向表现,即高分位收益反而更差;
不同样本期间的分位收益表现不一致,稳定性差。
2. 信息系数(IC)及其稳定性
关注点:IC衡量因子与未来收益的相关性,需查看IC均值、标准差、t值、IR(IC均值除以标准差)等。同时关注IC的时间序列稳定性,可视化滚动IC、统计正值比例。
好的表现:
IC均值显著为正或为负(取决于因子定义),且t检验通过显著性水平;
IC的波动较小,IR高(常见标准>0.5或>0.7);
滚动IC曲线平稳、长期在零以上(或以下),正值比例较高。
不佳表现:
IC接近0、t值不显著,说明因子几乎无法预测收益;
IC波动大、频繁变号,导致 IR 较低;
单一时期表现好但其他时期明显失效,稳定性不足。
3. 不同持有期表现
关注点:对因子信号采用不同持有期(如1天、3天、5天、10天等)回测,观察收益、夏普比、最大回撤随持有期的变化,从而确定最佳信号持有时间。
好的表现:
存在清晰的最佳持有期区间(例如持有3-5天收益/风险比最高),可指导交易执行;
在合理的持有期内(与策略频率、交易成本匹配),收益或风险调整收益稳定且显著。
不佳表现:
不同持有期表现差异巨大,缺乏明确峰值,说明信号难以实际运用;
最佳持有期过短或过长,与实际交易频率或成本约束不匹配;
持有期延长后收益迅速衰减或反向,说明信号只是一时噪音。
相关阅读
评论
登录后参与讨论,与站内账号体系共用。